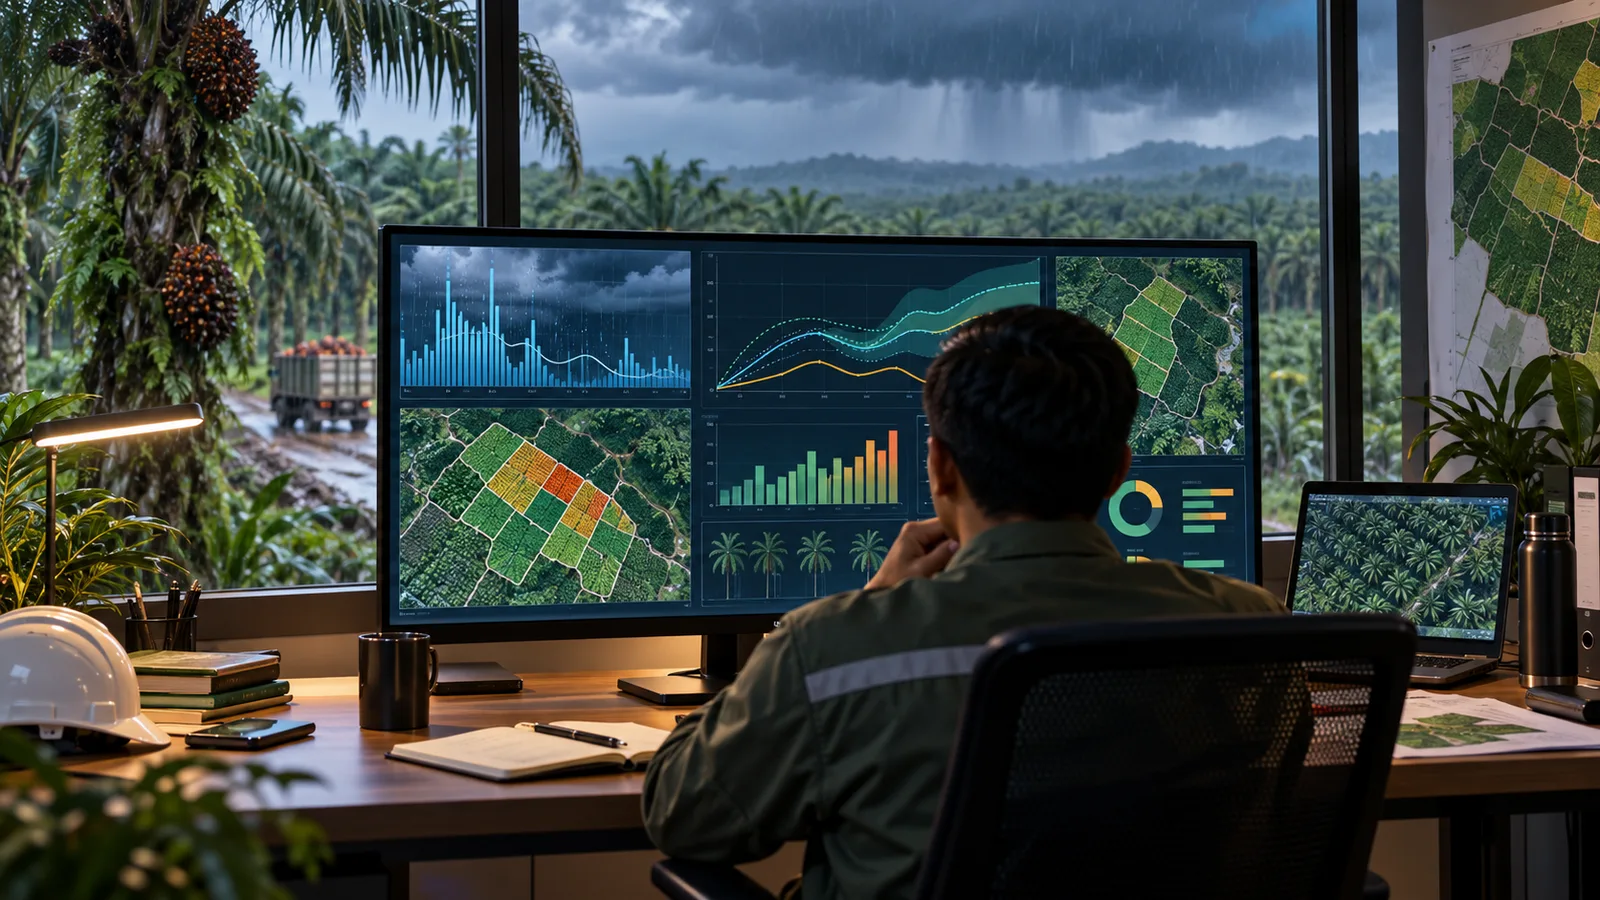
Prediksi produksi tandan buah segar (TBS) selama ini sering dibayangkan sebagai urusan catatan panen, luas tanaman menghasilkan, dan pengalaman lapangan. Dua artikel di Journal of Oil Palm Research (JOPR) menunjukkan bahwa pendekatan jaringan saraf tiruan atau artificial neural network (ANN) mulai dipakai untuk membaca pola yang lebih luas: dari curah hujan, defisit air, kondisi tanah, sampai variabel manajemen kebun. Bagi industri sawit, pelajaran utamanya bukan bahwa mesin dapat menggantikan keputusan lapangan, melainkan bahwa data yang rapi dapat membantu membaca produksi dengan cara yang lebih terukur.
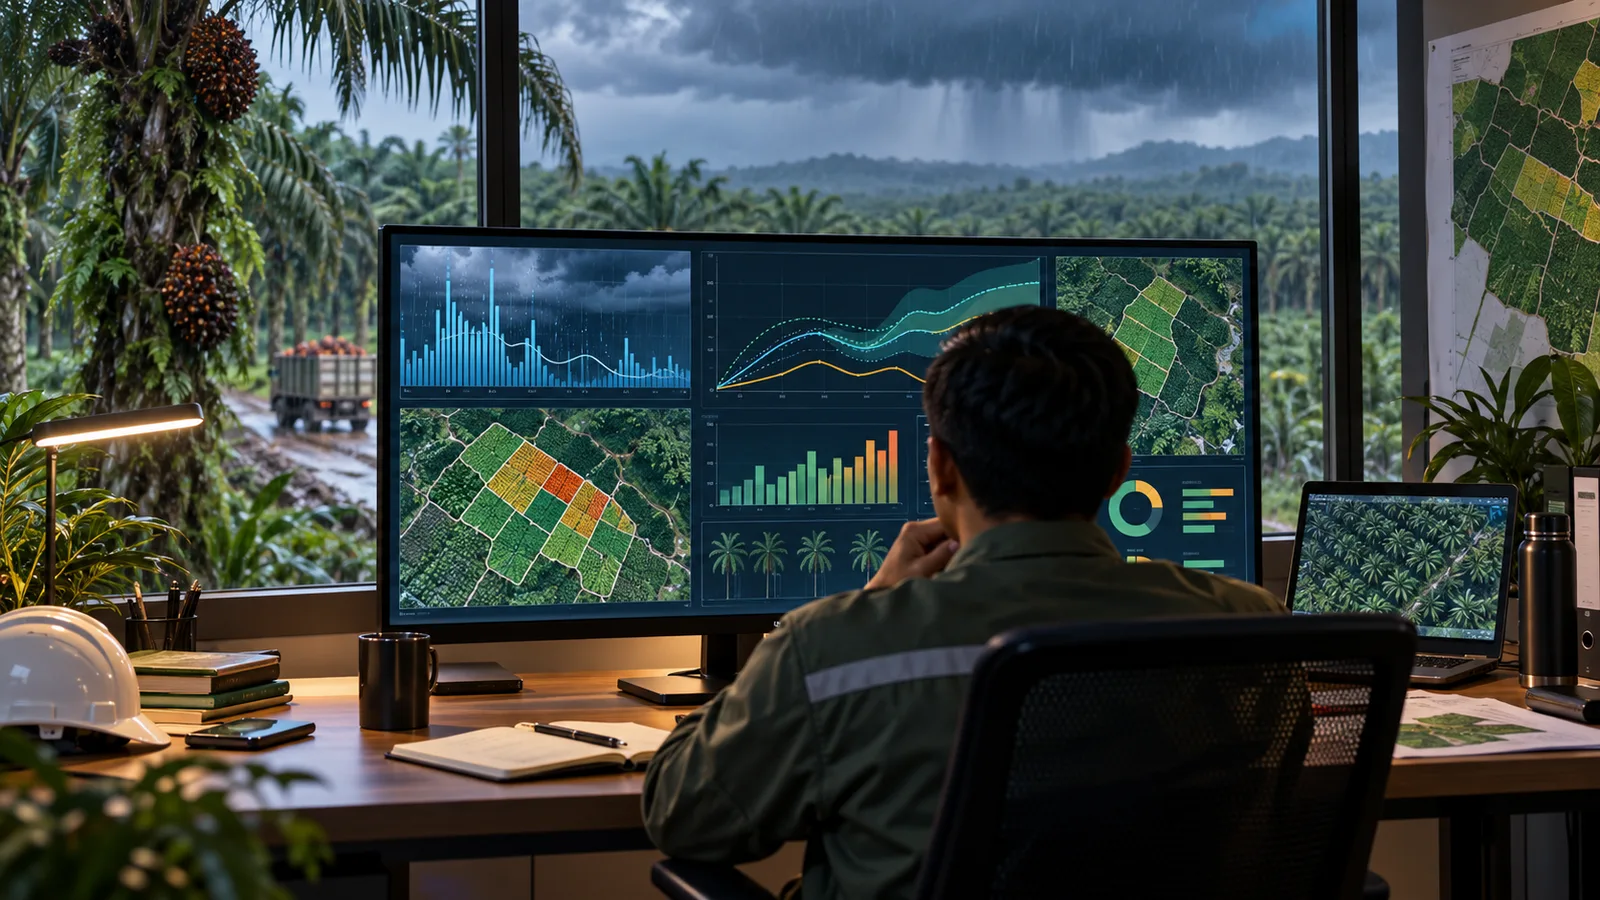
Apa yang dibaca ANN dalam produksi tandan
Studi “Prediction of Oil Palm Bunches Production Using Artificial Neural Network” bertujuan mengevaluasi kemampuan ANN untuk memperkirakan produksi bulanan tandan kelapa sawit saat ini. Variabel yang digunakan tidak berdiri pada satu kelompok data saja. Abstrak studi tersebut menyebut inventori, unsur iklim, defisit air, tanah, serta data registrasi dan manajemen perkebunan sebagai masukan model.
Hasilnya menunjukkan ANN mampu memperkirakan produksi saat ini dengan korelasi di atas 0,6 dan average percentage relative error sekitar 13%. Angka ini perlu dibaca sebagai ukuran kinerja pada konteks studi tersebut, bukan patokan universal untuk semua kebun, umur tanaman, wilayah, atau sistem pencatatan. Produksi tandan sendiri digambarkan sangat bervariasi, sehingga ruang perbaikan model masih terbuka.
Bagian yang menarik adalah komposisi variabel yang memberi kontribusi besar. Menurut ringkasan JOPR, variabel yang paling besar kontribusinya terhadap pemodelan berkaitan dengan manajemen, tanah, bahan genetik, dan penghitungan tandan matang. Variabel iklim dinyatakan tidak sepenting kelompok variabel tersebut dalam model, tetapi tetap perlu dipertahankan karena unsur iklim memang memengaruhi produktivitas sawit.
Dari iklim sampai polutan
Studi kedua, “Neural Networks Method in Predicting Oil Palm FFB Yields for the Peninsular States of Malaysia”, memberi contoh lain dengan cakupan data yang lebih luas. Artikel itu menyebut 19.440 dataset dan 15 variabel input untuk memprediksi hasil fresh fruit bunch (FFB) di negara-negara bagian Semenanjung Malaysia. Variabelnya mencakup persentase luas matang dan belum matang, curah hujan, hari hujan, kelembapan, radiasi, suhu, kecepatan angin permukaan, evaporasi, tutupan awan, serta polutan seperti O3, CO, NO2, SO2, dan PM10.
Model yang dikembangkan dalam studi tersebut mencakup ANN dan Non-linear Autoregressive Exogenous Neural Network (NARX). Keduanya kemudian divalidasi dengan dataset validasi independen. Dalam hasil yang dilaporkan, NARX berkinerja lebih akurat dibanding ANN umum dan multi linear regression (MLR), dengan koefisien determinasi R2 mencapai 97% serta mean square error (MSE) berada pada rentang 0,0104% sampai 0,0665%.
Perbandingan ini penting karena menunjukkan bahwa istilah neural network bukan satu bentuk tunggal. ANN dapat merujuk pada keluarga model yang luas, sedangkan NARX memasukkan struktur autoregresif non-linear dengan variabel eksogen. Dalam bahasa sederhana, NARX tidak hanya membaca hubungan antarvariabel pada satu titik, tetapi juga membawa unsur urutan atau ketergantungan waktu. Namun, seperti studi pertama, hasil tersebut tetap melekat pada data, wilayah, dan rancangan penelitian yang digunakan.
Data cleaning sebelum model belajar
Kedua studi menempatkan data sebagai bahan baku utama. Dalam praktik pemodelan seperti ini, data cleaning menjadi tahap yang menentukan sebelum model dilatih. Istilah ini dapat mencakup pemeriksaan kelengkapan data, kesesuaian satuan, konsistensi periode, pencocokan data kebun dengan data iklim, serta penanganan nilai yang hilang atau tidak wajar. Artikel JOPR tidak perlu dibaca sebagai panduan operasional rinci untuk semua perusahaan, tetapi ia menegaskan bahwa model hanya sebaik data yang masuk ke dalamnya.
Untuk produksi TBS, risiko data kotor bisa datang dari banyak titik: pencatatan luas tanaman menghasilkan yang tidak mutakhir, perbedaan definisi blok, catatan curah hujan yang putus, atau hitungan tandan matang yang tidak konsisten. Jika data seperti itu langsung masuk ke model, galat prediksi dapat terlihat seperti masalah algoritma, padahal sumbernya mungkin berada pada proses pencatatan. Karena itu, pembicaraan tentang ANN di kebun sebaiknya tidak dimulai dari model semata, tetapi dari disiplin data.
Train, validasi, dan galat prediksi
Dalam pengembangan neural network, data biasanya dibagi untuk pelatihan dan pengujian atau validasi. Studi kedua secara eksplisit menyebut validasi menggunakan dataset independen. Tujuan tahap ini adalah melihat apakah model hanya “hafal” pola data latihan atau benar-benar mampu membaca data yang tidak dipakai saat pelatihan. Validasi seperti ini penting terutama untuk komoditas yang dipengaruhi musim, lokasi, umur tanaman, dan perubahan praktik budidaya.
Ukuran galat juga perlu dibaca dengan hati-hati. Studi pertama menyebut average percentage relative error sekitar 13%, sedangkan studi kedua menampilkan MSE yang sangat kecil untuk NARX dan R2 sampai 97%. Angka-angka tersebut memberi sinyal bahwa model dapat menangkap pola pada data penelitian, tetapi tidak otomatis berarti setiap prediksi lapangan akan presisi pada tingkat yang sama. Perbedaan kualitas data, perubahan cuaca ekstrem, gangguan panen, atau perubahan manajemen dapat menggeser kinerja model.
Karena itu, galat prediksi sebaiknya diperlakukan sebagai bagian dari keputusan, bukan disembunyikan. Jika model memprediksi produksi bulanan, pengguna perlu tahu kisaran ketidakpastian dan riwayat kesalahan model. Dengan begitu, hasil prediksi dapat menjadi alat bantu membaca kemungkinan produksi, bukan angka tunggal yang dianggap pasti.
Manfaat praktis yang perlu dibaca hati-hati
JOPR menyebut prediksi produksi yang andal dapat menjadi dasar keputusan untuk budgeting, storage, distribution, dan marketing. Dalam konteks rantai pasok sawit, kalimat ini dapat diterjemahkan secara hati-hati ke beberapa kebutuhan operasional. Prediksi produksi yang lebih terbaca dapat membantu perkebunan menyusun anggaran, memperkirakan kebutuhan ruang penampungan, mengatur distribusi, dan menyiapkan rencana pemasaran.
Untuk tenaga kerja, prediksi TBS berpotensi menjadi bahan masukan saat menyusun kebutuhan panen dan pekerjaan pendukung. Untuk angkutan, prediksi dapat membantu membaca kapan beban pengiriman ke pabrik kelapa sawit (PKS) mungkin meningkat. Untuk PKS, prediksi produksi dapat menjadi salah satu bahan dalam memperkirakan penerimaan TBS, antrean, dan kebutuhan koordinasi dengan kebun. Namun semua itu harus diposisikan sebagai interpretasi kehati-hatian dari kegunaan budgeting, storage, distribution, dan marketing yang disebut sumber, bukan janji bahwa satu model akan otomatis menyelesaikan persoalan tenaga kerja, truk, atau kapasitas pabrik.
Pendekatan ini juga relevan untuk pelaku yang ingin mengikuti perkembangan teknologi sawit tanpa kehilangan konteks kebun. Model statistik dan neural network dapat membaca pola, tetapi pola itu tetap berasal dari aktivitas nyata: tanaman, tanah, cuaca, pencatatan, panen, dan pengelolaan. Untuk pembaca yang ingin mengikuti artikel edukasi lain, rubrik Wawasan GIMNI dapat menjadi pintu masuk ke pembahasan industri sawit dan minyak nabati secara lebih luas.
Batas yang tidak boleh dilompati
Dua artikel JOPR tersebut sama-sama memberi pesan bahwa neural network berguna, tetapi bukan alat ajaib. Studi pertama bahkan menyebut perlunya studi lanjutan dengan kombinasi dan penggunaan variabel baru untuk meningkatkan akurasi estimasi. Ini berarti pengembangan model produksi TBS masih bergerak, terutama karena produksi sawit sangat variabel dan dipengaruhi banyak faktor.
Batas lain adalah konteks wilayah. Studi Malaysia memakai data negara-negara bagian Semenanjung Malaysia, sedangkan studi produksi tandan bulanan memakai variabel inventori, iklim, defisit air, tanah, registrasi, dan manajemen perkebunan dalam konteks penelitian yang berbeda. Hasil dari satu lokasi tidak bisa langsung ditempelkan ke lokasi lain tanpa pengujian ulang. Setiap kebun atau perusahaan yang ingin memakai pendekatan serupa perlu memastikan definisi data, periode observasi, dan proses validasinya sesuai dengan kondisi sendiri.
Karena itu, cara paling aman membaca ANN untuk prediksi TBS adalah sebagai kerangka pendukung keputusan. Ia membantu mengubah data kebun dan lingkungan menjadi estimasi yang dapat diuji. Ia juga memaksa organisasi memperbaiki data cleaning, membagi data untuk train dan validasi, serta membicarakan galat prediksi secara terbuka. Jika dipakai dengan disiplin seperti itu, neural network dapat memperkaya percakapan tentang target panen tanpa mengubah prediksi menjadi kepastian.
Sumber pantauan
https://jopr.mpob.gov.my/prediction-of-oil-palm-bunches-production-using-artificial-neural-network